一键优化提示词:让 AI 更懂你的画面,避免生成跑偏
选中图片节点,点击「一键优化提示词」,AI 会按你的创作模式、时长和分辨率重写提示词,并保留分镜细节,应用前可预览对比。
从一个常见卡点开始
在画布上写提示词时,经常遇到几个头疼问题:从微信或网页复制来的文字,粘贴进提示词框后看着有字,生成时却提示空词;自己写的提示词不够结构化,AI 生成时容易跑偏,比如把视频需求判成图片、时长对不上、画质参数写错;长提示词里塞满重复形容词和负向要求,反而干扰生成。
让创作流程留在同一张画布
知视云在画布图片节点上提供「一键优化提示词」:后端调用 LLM 把提示词改写成结构化 JSON,再由代码渲染成最终模板。系统以你在 UI 里选的模式(视频/图片)、时长、分辨率为准,LLM 只负责提炼正文和负向清单,画质尾按分辨率自动生成,负向要求统一压缩成一句。优化结果先在弹窗里预览,确认后才应用到提示词框,应用前绝不改动原词。
两段式优化:LLM 只出 JSON,代码渲染模板
传统做法让 LLM 直接输出整段提示词,容易把模式、时长、画质这些可程序化守住的参数写错。知视云把这件事拆成两段:LLM 只输出结构化 JSON(任务类型、时长、正文、负向清单),代码负责渲染最终模板。
这样,UI 里选的模式(视频/图片)和时长就是权威值,LLM 的判断只作参考,不一致时以 UI 为准并给出告警。画质尾按当前模型和分辨率生成,不再固定写「4K超高清」;负向要求由 LLM 抽成数组,代码统一压成「全程无…」一句,避免长列表和重复。
摘要与保留分镜两种风格,适配不同需求
优化时可以选择「摘要」或「保留分镜」风格。摘要风格会把每个时间段压缩到 2-3 个关键动作,合并重复接触点,适合快速生成;保留分镜风格则保留每个时间段的主要动作链和关键打击点,不过度合并,适合需要精细控制分镜的复杂提示词。
两种风格都会删除重复形容词和同义动作,并控制正文长度:复杂分镜摘要 400-700 字、保留分镜 600-1000 字;简单提示则更短。图片模式会扩写成具体可拍摄画面,正文控制在 100-250 字。
应用前预览,绝不擅自改原词
优化结果不会直接覆盖你的提示词。点击「一键优化提示词」后,弹窗里展示优化后的正文、任务类型、时长和告警信息,你可以对比原文和优化结果,选择「应用」或「放弃」。
只有点击应用,优化后的提示词才会写入节点真源;关闭弹窗或放弃都不会改动原词。如果优化失败(比如超时或返回非法 JSON),系统保留原提示词并给出重试入口,不会让你丢失已写的内容。
可以这样开始
- 选中图片节点
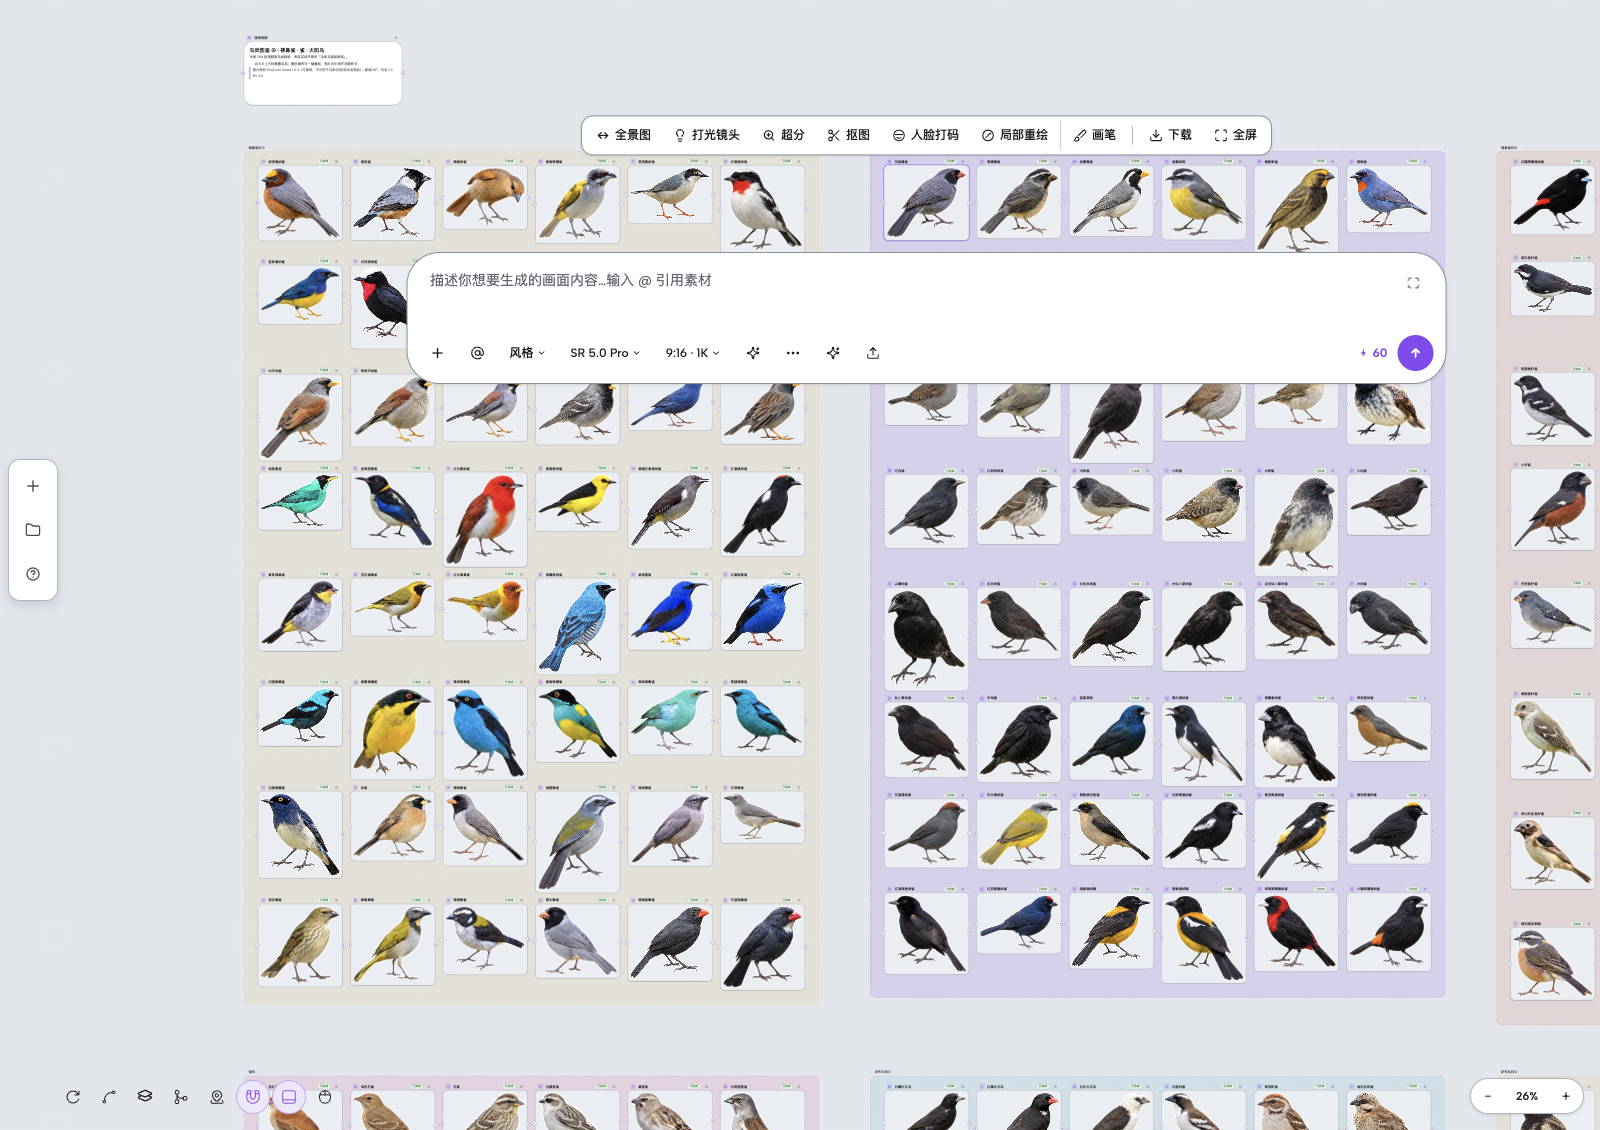
在画布中点击选中一个图片节点,节点上方出现图片工具条,下方显示提示词框。
- 输入或粘贴提示词
在提示词框里输入描述,或从微信/网页复制文字粘贴进来。粘贴时会自动归一化为纯文本,内联标签里的正文不会丢失。
- 点击「一键优化提示词」
在提示词框的工具按钮中找到「一键优化提示词」并点击,系统会调用 AI 进行结构化改写。
- 预览优化结果
弹窗中展示优化后的正文、任务类型、时长和告警信息,可切换摘要/保留分镜风格,对比原文。
- 应用或放弃
确认无误后点击「应用」,优化后的提示词写入节点;不满意可点击「放弃」或关闭弹窗,原词保持不变。